Jev AI 教程:申请 waitlist、API 调用与三个原语
前面一篇讲了 Jev AI 是什么,这篇直接上手:怎么申请、怎么装 SDK、怎么跑通第一个调用,以及 Choice / Score / Noul 三个原语到底怎么写代码。代码都按 2026-09-19 能查到的公开资料整理,跑不通或存疑的地方我会标“待验证”,不写假代码。
第一步:申请 waitlist,拿到 API key
Jev 目前是 early access(抢先体验)阶段:
- 打开 typesafe.ai 官网,找到 waitlist / early access 入口,提交申请。(待验证:申请通过周期官方没说,按新发布模型的惯例,几天到几周都有可能)
- 通过后登录 console.typesafe.ai,在控制台里创建并复制你的 API key。
- 把 key 存进环境变量,别写死在代码里:
export TYPESAFE_API_KEY="你的key"不想等 waitlist? Vercel AI Gateway 上已经上架了 typesafe-ai/jev,有 Vercel 账号的话可以直接走 Gateway 调用。(待验证:Gateway 上的计费与直连是否一致,调用前先看一眼 Gateway 的定价页)
第二步:装 SDK
Python:
pip install typesafe-sdkNode.js:
npm install @typesafe-ai/sdk(待验证:Node 包的导入方式与 Python 是否完全对应,下面代码示例以 Python 为准,Node 请以官方文档为准)
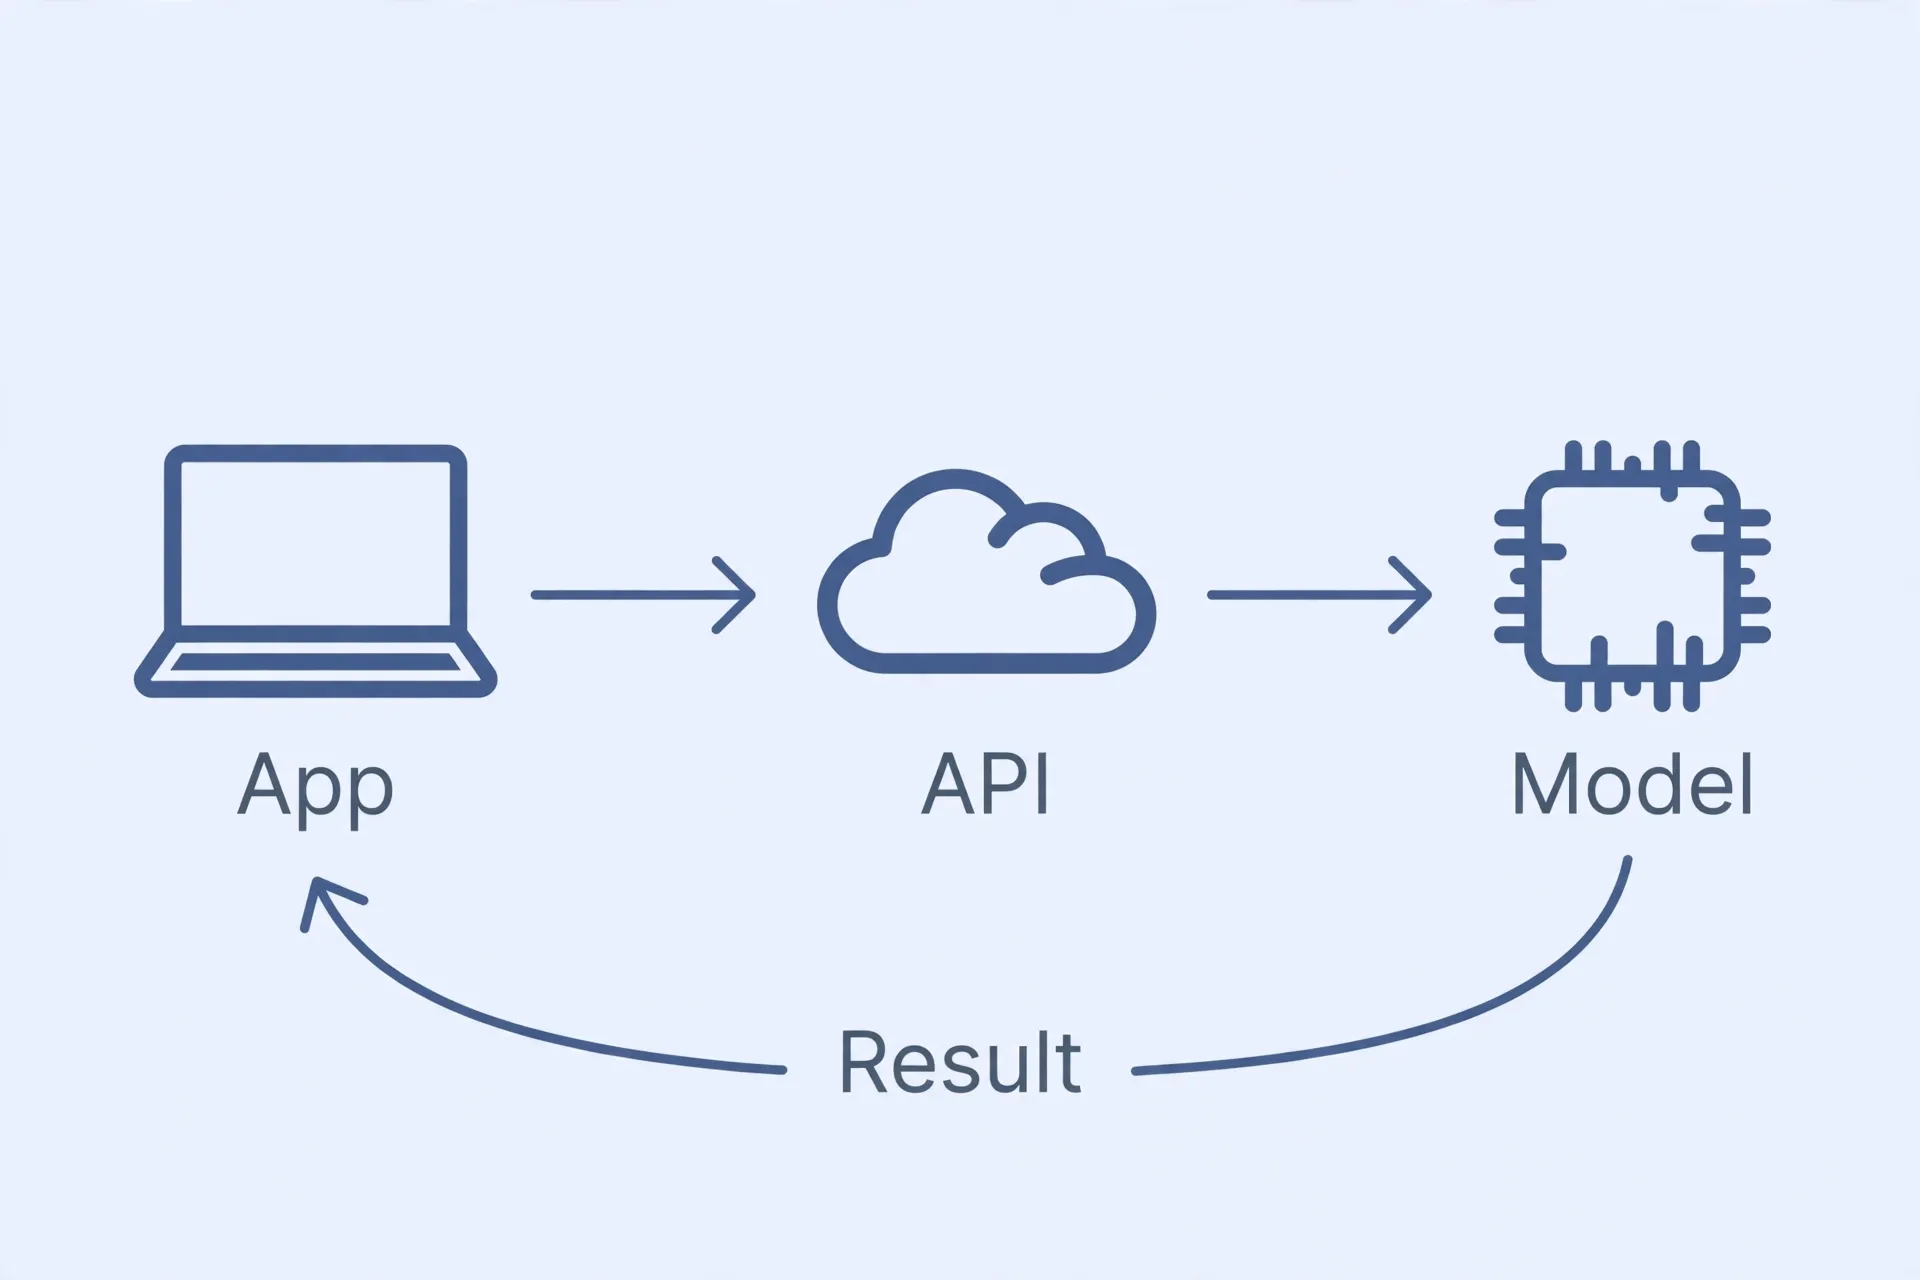
另外还有一个直接调 HTTP 的方式,不用装 SDK:
POST https://api.typesafe.ai/v1/systemone适合你想先 curl 试一把、或者用的语言没有官方 SDK 的情况。请求体结构和 SDK 的 system_one(state=..., questions=...) 对应。
第三步:第一个调用——工单分流
这是官方文档里的经典例子,也是后面搞钱篇要用的场景:一封客服工单,问三个问题,一次返回。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

# 客户端默认从环境变量 TYPESAFE_API_KEY 读 key
client = TypeSafeClient()

ticket = {
    "message": "I was charged twice for order A-104. Please refund.",
    "plan": "annual",
    "amount_usd": 499,
}

response = client.system_one(
    state=ticket,
    questions={
        # Choice:这张单子归哪个团队?
        "department": Choice(
            instructions="Which team should handle this request?",
            criteria={
                "billing": "Payment, subscription, cancellation, or refund issue",
                "technical": "Product bug or integration problem",
                "sales": "Pricing or purchasing question",
                "other": "None of the options clearly fits",
            },
        ),
        # Noul:客户是否明确要求退款?返回 0~1 的概率
        "refund_requested": Noul(
            instructions="Does the customer explicitly request a refund?",
        ),
        # Score:客户有多生气?返回落在刻度之间的分数
        "frustration": Score(
            instructions="How frustrated does the customer appear?",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
    },
)

department = response.answers["department"]
print(department.choice)         # 比如 "billing"
print(department.probabilities)  # 每个选项的概率,比如 {"billing": 0.85, ...}
print(department.confidence)     # 置信度

refund = response.answers["refund_requested"].noul  # 比如 0.92
frustration = response.answers["frustration"].score # 比如 1.035,可以落在刻度之间
读返回值的三个要点:
choice是选出的选项,probabilities是每个选项的概率——两个都要看,别只看第一名。confidence是根据概率分布算出来的“有多确定”。比如 technical 0.84、billing 0.16,confidence 可能只有 0.6 左右——因为还有 16% 的不确定性悬着。- Noul 没有 confidence 字段,因为返回的那个 0~1 数字本身就是信念强度。
生产环境必须加的一行(阈值路由):
if department.confidence >= 0.70:
    route_to(department.choice)
else:
    route_to("human_review")  # 不确定就转人工,别硬上
阈值 0.70 只是示例,一定要用你自己的标注数据调,别抄。
三原语详解
Choice:选择题(最多 255 个选项)
- 用法:
Choice(instructions="...", criteria={"选项key": "一句话描述", ...}) - criteria 是字典,key 是选项名,value 是给模型的描述——写清楚点,模型就准点。
- 一定要加一个
other选项(“以上都不符合”)。如果你逼它在一个覆盖不全的列表里选,它会选一个“最不离谱的错误答案”——这是官方文档明确提醒的坑。 - 返回:
.choice、.probabilities、.confidence。
Score:打分题(2~10 个有序等级)
- 用法:
Score(instructions="...", criteria=["等级1", "等级2", ...]) - criteria 是有序列表,从低到高,等级 0 就是第一个。
- 返回的
.score可以落在等级之间(比如 1.035),外加.probabilities和.confidence。 - 适合:情绪分级、线索质量、内容风险等级——任何“是个光谱”的东西。
Noul:是非题(返回 0~1 概率)
- 用法:
Noul(instructions="..."),一句话把要判断的陈述写清楚。 - 返回
.noul:一个 0 到 1 的数字,就是“是”的概率。 - 适合:是否紧急、是否要求退款、是否违规——任何二值判断。
五个可以直接抄的模式
- 客服分流:Choice 选部门 + Noul 判紧急度 + Score 判情绪,一次调用三个问题全问完。
- 线索打分:Score 给销售线索打 1~5 级,配合 Noul 判“是否值得立即跟进”。
- 内容审核分级:Score 判风险等级,confidence 低的转人工。
- Agent 工具路由:用户一句话进来,Choice 决定调哪个工具(每个工具的描述就是 criteria),调完再把结果丢给 LLM 生成回复——“Jev 判、LLM 说”的分工。
- 退款/审批校验:Noul 判“是否符合自动退款条件”,过了阈值才自动执行,否则转人工。
计费:算一笔账
- $0.042 / 百万输入 tokens,输出免费。
- 官方 Doom demo:10Hz 实时决策,玩一小时约 $7。
- 一个客服工单分流调用,输入大概几百到几千 tokens——按 2000 tokens 算,一次调用约 $0.000084,也就是一万次调用不到 1 美元。这就是它敢叫板 LLM 做分类的底气。
(待验证:waitlist 阶段是否有免费额度,官方没明确说,先按付费价做预算)
失败模式:它会在哪里翻车
- 选错合法选项:Jev 保证输出格式合法,但不保证选对。confidence 就是给你看“它自己有多虚”的——低了就转人工。
- 没有 other 选项的 Choice:输入超出选项覆盖范围时,它会硬选一个最不离谱的。解法:永远加 other。
- 分布漂移:训练时没见过的输入类型,校准的置信度可能失真。上线前用自己的真实数据测一轮,别信 demo。
- 阈值拍脑袋:0.7 还是 0.9,要用标注数据调。没调过的阈值等于没设。
调试小技巧:第一次调用没跑通先查这三处
- 401/403:先看
TYPESAFE_API_KEY是不是 export 到当前 shell 了,echo $TYPESAFE_API_KEY看一眼;key 前后有没有多复制了空格或换行。 - 返回全是 other / confidence 奇低:criteria 描述写得太模糊,或者输入根本不在选项覆盖范围内——先把 state 写得更具体,或者放宽选项。
- 延迟偶发飙高:官方给的是 70–500ms 区间,抖动正常;连续超时先查自己的网络,再考虑是不是一次问了太多 question,拆成两次调用试试。(待验证:多 question 对延迟的影响量级,官方没给数字)
FAQ
Jev 教程:申请 waitlist 要多久?
官方没公布通过周期。等不及可以走 Vercel AI Gateway 上的 typesafe-ai/jev,不用等 waitlist。
Jev 的 Python SDK 怎么装?
pip install typesafe-sdk,代码里 from typesafe_sdk import Choice, Noul, Score, TypeSafeClient,key 放环境变量 TYPESAFE_API_KEY。
Jev 和 LLM 的 structured output 有什么区别?
LLM 的 structured output 是“先写文本、再约束格式”,Jev 是“直接输出类型化决策”,没有生成文本这一步。所以更快(70–500ms)、更便宜(输出免费),但也只能做决策,不能生成内容。
Jev 的 confidence 可信吗?
它是根据概率分布算出来的“确定程度”,比 LLM 自己报的“我很确定”要靠谱一些,但分布漂移时也会失真。生产环境一定要用自己的标注数据校准阈值。
不用 SDK 能直接调吗?
可以:POST https://api.typesafe.ai/v1/systemone,请求体带 state 和 questions,结构与 SDK 对应。
想知道这套能力具体怎么卖钱、卖给谁,看下一篇《用 Jev 搞钱:工单分类、线索打分、Agent 路由》。
参考资料
- TypeSafe 官网 — 官方文档与 early access 申请入口;正文“第一步”里 waitlist 申请、console.typesafe.ai 创建 API key 的入口依据。
- Jev API, Pricing & Playground | Vercel AI Gateway — Vercel AI Gateway 上
typesafe-ai/jev的模型页:模型 ID、$0.042/百万输入 tokens 定价、输出免费;支撑正文“不想等 waitlist”段与“计费”段。 - How to classify, route, and score with Jev and AI SDK | Vercel 知识库 — 三原语(choice/score/boolean)在 AI SDK 侧的用法与限制(最多 255 个选项、2~10 个等级),与正文“三原语详解”互相印证。
订阅后你会先收到一份「7 天验证清单」。
免费订阅