Jev vs 开源平替:该付费用官方 API,还是自己训一个?
Jev 值不值得付费,还是该找个开源平替自己训? 这是个真问题——Jev 发布刚一周多,社区就冒出了几十个“开源版 Jev”,有的自称比官方更快,有的自称更准。这篇把能找到的自报数据摆出来,附一份决策清单。
先看数据:社区自测结果汇总
下面的数字全部来自各项目自己公布的测试结果,不是我们独立复测过的,测试方法和数据集也不统一——放在一起看趋势可以,别当成精确排名。
| 项目 | 自报数据 | 备注 |
|---|---|---|
| openJev-verdict-2.0 | 151M 参数,77.10% 准确率,声称在 LocalLLaMA/typed-decisions 上“击败 TypeSafe Jev & Laya” | 项目自己的评测集,未见第三方复现 |
| open-jev-typed-decision-engine | 0.697 分(Jev 自己是 0.727)、校准好 2.5 倍、快 4 倍、免费,Colab T4 上 30 分钟能训完 | 准确率略低于 Jev,但强调“够用 + 免费 + 可自己练” |
| AnyJev | 把任意 LLM 改造成 Jev 风格的决策模型,不需要训练 | 适合“手头已经有模型,不想额外接一个新服务”的场景 |
| von | 声称延迟低于 15ms,本地部署、非自回归 | 定位是“本地 drop-in 替代” |
| Verdict (Open-jev) | 151M ModernBERT,0.83% 自适应校准误差,反转选项顺序时 3.0% 预测会变 | 附带在浏览器里跑的 WebGPU demo,可以自己试 |
作为参照,Jev 官方定价是 $0.042/M 输入 tokens、输出免费——对大多数场景来说,官方价格本身已经便宜到“值不值得自建”更多是隐私和控制权的问题,不是纯粹的成本问题。
决策清单:付费 vs 自建
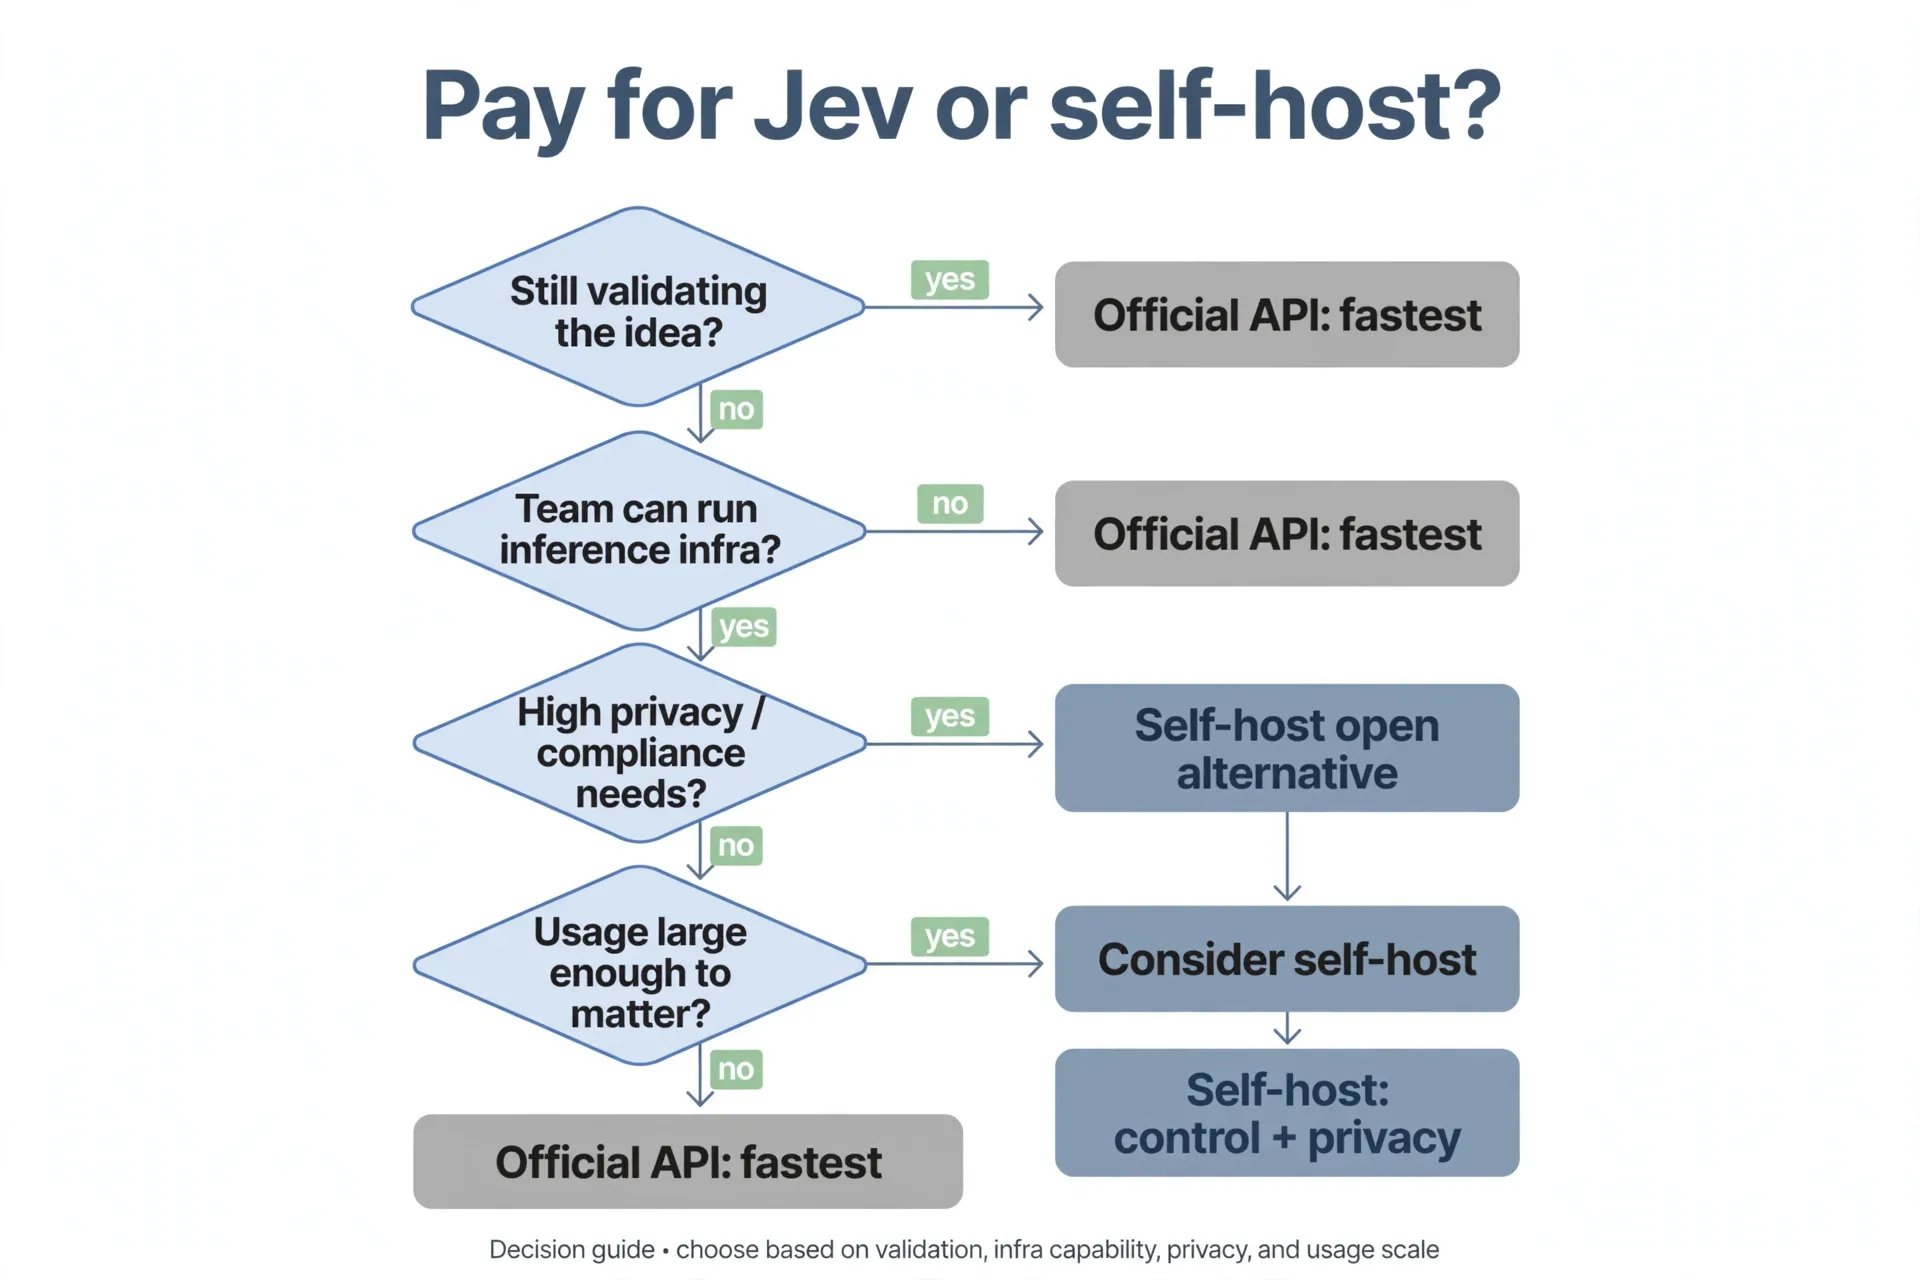
直接用 Jev 官方 API,别折腾,如果满足以下任意一条:
- 还在验证业务想法,没确定要长期做——先用最快能跑起来的方案。
- 团队没有维护推理服务/GPU 部署的经验。
- 用量小——按 $0.042/M 输入估算,大多数中小规模场景一个月成本是几美元到几十美元,折腾自建省下的钱可能还不够付你自己的时间。
考虑自建开源平替,如果满足以下任意一条:
- 处理的内容涉及隐私/合规要求,不能发到第三方 API(医疗、法务、金融相关数据尤其要小心)。
- 用量已经大到即使官方的低价也变成一笔可观开支。
- 团队本来就有维护推理服务的能力,想要完全的部署控制权、不想依赖一个还在 waitlist 阶段的早期产品。
一个现实因素:Jev 目前还是 waitlist / early access 状态(见 Jev AI 是什么)。如果申请还在排队而业务等不了,AnyJev 这类“直接改造你已有的模型”的方案可以先用起来验证想法,等官方批下来了再评估要不要切换。
一个顺带的服务思路
如果你已经读到这里,说明你对这个决策本身有判断力——这本身可以是一个轻量咨询服务:帮小团队做“到底该付费还是自建”的技术选型评估,比自己从头研究几十个开源项目省时间。参考 Jev 工单分类接单指南 里的报价逻辑,这类一次性技术选型咨询通常按小时或按项目报价,比长期服务更容易起步。
FAQ
这些开源平替真的比 Jev 便宜/快吗? 按各自项目自报的数字,是的——但这些数字是项目作者自己测的,方法论、测试集都不一样,不是同一套标准下的横向对比。拿它们当“方向性参考”而不是“精确排名”。
什么情况该直接付费用 Jev,不折腾自建? 三种情况:① 还在验证阶段、没确定要不要长期做这个业务,先用官方 API 跑最快;② 团队没有维护推理服务的技术能力;③ 用量小到官方定价本来就便宜到可以忽略($0.042/M 输入,绝大多数场景一个月几美元)。
什么情况该考虑自建? 数据隐私要求高、不能把内容发到第三方 API;用量大到即使 Jev 的低价也开始变成一笔可观的成本;或者团队本来就有维护推理服务的能力,想要完全的部署控制权。
Jev 本身还是 waitlist 状态,这会不会影响选择? 会。如果你申请 Jev 还在排队,而业务等不了,开源平替(尤其是 AnyJev 这种“用你已有的 LLM 直接改造”的方案)可以先用起来验证想法,等 Jev 批下来了再对比切换成本。
参考资料
- openJev-verdict-2.0
- open-jev-typed-decision-engine
- AnyJev
- von
- Verdict (Open-jev)
- TypeSafe AI 官网 — 官方定价与 waitlist 申请入口。
- awesome-jev — 完整的开源平替列表在 “Benchmarks & research” 分类下,本文只挑了有具体数据的几个。
别只是读完,这周就去跑第一单
订阅后你会先收到一份「7 天验证清单」。
免费订阅