Jev 替代品:6 个开源平替、LLM 分类器,怎么选(2026 年 10 月)
Jev 替代品:6 个开源平替、LLM 分类器,怎么选(2026 年 10 月)
有,真的有 Jev 替代品——而且分四个桶:(A) 能自己部署的开源 Jev 同类模型,好几个兼容 Jev API;(B) Jev 兼容的本地服务,换个 base URL、客户端代码一行不用动;(C) Jev 想干掉的 incumbent——拿 大 LLM 当分类器用;(D) 传统分类器,XGBoost 和微调 BERT,标签固定时依然能打。选哪个桶,看你要优化什么:成本、数据控制、准确率,还是省事。
先说清楚分工,避免你白读:本站已经有一篇 Jev vs 开源平替:该付费还是自建?,那篇是“付费还是自建”的完整算账。本页是替代品目录 + 选型指南——先看有什么可选、再决定怎么选,两篇不重复。
A 桶:能自己部署的开源 Jev 平替
社区动作快得离谱——Jev 发布 48 小时内就冒出 6 个以上的克隆(explainx.ai 有专门的 sprint 盘点),awesome-jev 这个 GitHub 列表现在收录了 15+ 个替代项目。下表以 DataCamp 那篇 7 项目横评为骨架:
| 模型 | 规模与底座 | 特点 |
|---|---|---|
| Laya | 322M–421M,ModernBERT-large + PPO(Apache 2.0) | 多语言(100+);laya-serve 直接暴露 Jev 兼容接口 |
| Kev | 0.8B–9B,Qwen + LoRA + pointer head(Apache 2.0) | 最接近无痛替换——TypeSafe SDK 据说不改代码就能连 |
| Bespoke Nimble | 9B,Qwen3.5-9B + LoRA | 作者自称数据清洗后准确率从 66% 拉到 90% |
| Von | ~395M | 中等硬件上延迟低 |
| Decider | 2B / 4B / 35B MoE | vLLM 部署,规模和质量自己权衡 |
| NanoJev | 0.6B | 训练→评测→部署一条龙,一个仓库搞定 |
说句诚实话,来自独立测试:xbill 那篇《Jev 发布八天的独立测试》抠了准确率和校准,armanjr 的 Jev-vs-Laya 波斯语 benchmark 里 Jev 可重复性 48/48 全胜。公平的结论是:Jev ≈ 中档 LLM 的准确率,成本约 1/200;开源平替校准差半档,但免费、能自己部署。 自建的话,评测预算要自己留——别把人家 README 里的数字当真。
B 桶:Jev 兼容本地服务(客户端代码不动)
不想动应用代码?这些服务说 Jev 的 API 方言,迁移就是换个 base URL:laya-serve、Arbiter、Rust 写的 sys1,还有自称“决策模型界 Ollama”的 ollaya(9 月 26 日发布)。dev.to 上那篇被广泛转发的自建指南把路径写得很清楚:拉一个 A 桶模型 → 套其中一个服务 → 把原来打给 Jev 的客户端指向 localhost。这是你先在托管版 Jev 上跑通原型、之后因为数据主权或边际成本要迁出来时,摩擦最小的下车坡道。
C 桶:LLM 当分类器(Jev 想替换的 incumbent)
Jev 之前,“分个类”意味着调 GPT-5.6 Terra/Sol 或 Claude Sonnet/Opus/Fable 5.1,加 structured output,再祈祷 JSON 能解析。这套仍是准确率天花板:TypeSafe 自家评测——这个归因看清楚,是厂商自己的主场——GPT-5.6 Sol 74.1% 对 Jev 67.8%。但 LLM 分类器单次决策贵 20–400 倍。为 ~6 个点多花两个数量级的钱,只在“分错一次代价很大、量又不大”的场景(医疗、法律、金融分拣)说得通。
D 桶:传统分类器(XGBoost、微调 BERT)
不时髦,但有一种题型至今无敌:标签集合固定 + 有标注训练数据 + 不需要超出领域的语言理解。微调 BERT 甚至 XGBoost + embedding,在这种题上成本吊打上面所有选项、准确率经常也不输——代价是训练、重训、漂移监控全归你。explainx.ai 发过一篇 Jev-vs-XGBoost/BERT 的对比,想看这个角落的数字可以去翻。
诚实数学:准确率 vs 成本
这是大多数盘点跳过的部分,但恰恰是它决定一个替代品是真省钱,还是把成本挪了个地方。
准确率差距真实存在,但不大。 TypeSafe 自家评测——他们自己的 benchmark、自己的主场,所以按“厂商最优口径”理解——GPT-5.6 Sol 74.1% 对 Jev 67.8%。独立测试给出的诚实 headline 是:Jev 拿出约中档 LLM 的准确率,成本约 1/200。 开源平替在校准和可重复性上再落后半档(记得 armanjr 那个 48/48),但不要钱。
每百万次决策,大概多少钱:
| 方案 | 每百万次决策成本 | 你要付出的代价 |
|---|---|---|
| 托管版 Jev | 输入 $0.042/M,输出免费(官方价) | 数据出你的 infra;按量计费 |
| 自建平替(Kev/Laya) | 边际成本 ~$0(自己的 GPU) | 评测、校准、可用性全自己扛 |
| LLM 分类器 | Jev 的 20–400 倍 | 准确率没得说——但账单也是 |
| XGBoost / 微调 BERT | 边际成本 ~$0(自己的 infra) | 训练、重训、漂移监控 |
“不会幻觉” ≠ “不会错”。 这句话被当咒语念,所以精确地拆一下:它的意思是模型不会输出 schema 之外的东西——每个答案都是你集合里的合法标签。但合法标签也可能是错标签。Jev 消灭的是一种特定失败模式(解析不了的 JSON、凭空发明的类别),不是“答错”这件事。如果你的场景惩罚的是“答错”而不是“格式错”,校准测试跟以前一样重要,一点都不能省。
选型指南:什么情况选什么
- 这周就要原型,没 infra → 托管版 Jev。先领 $5 额度,照着 Jev 上手指南 跑通,把东西发出去。
- 量起来了,或数据不能出 VPC → 自建 Kev(替换最无痛)或 Laya(要多语言),套一个 B 桶服务。推理边际成本掉到 ~$0。
- 分错一次很贵、量不大 → LLM 分类器(GPT-5.6 Sol / Claude)+ structured output。20–400 倍的溢价,清醒地付。
- 标签固定、有标注数据、领域稳定 → XGBoost / 微调 BERT。无聊但便宜,赢。
- 已经在 Jev 上建好了,只想下表 → B 桶服务换 base URL,客户端一行不动。
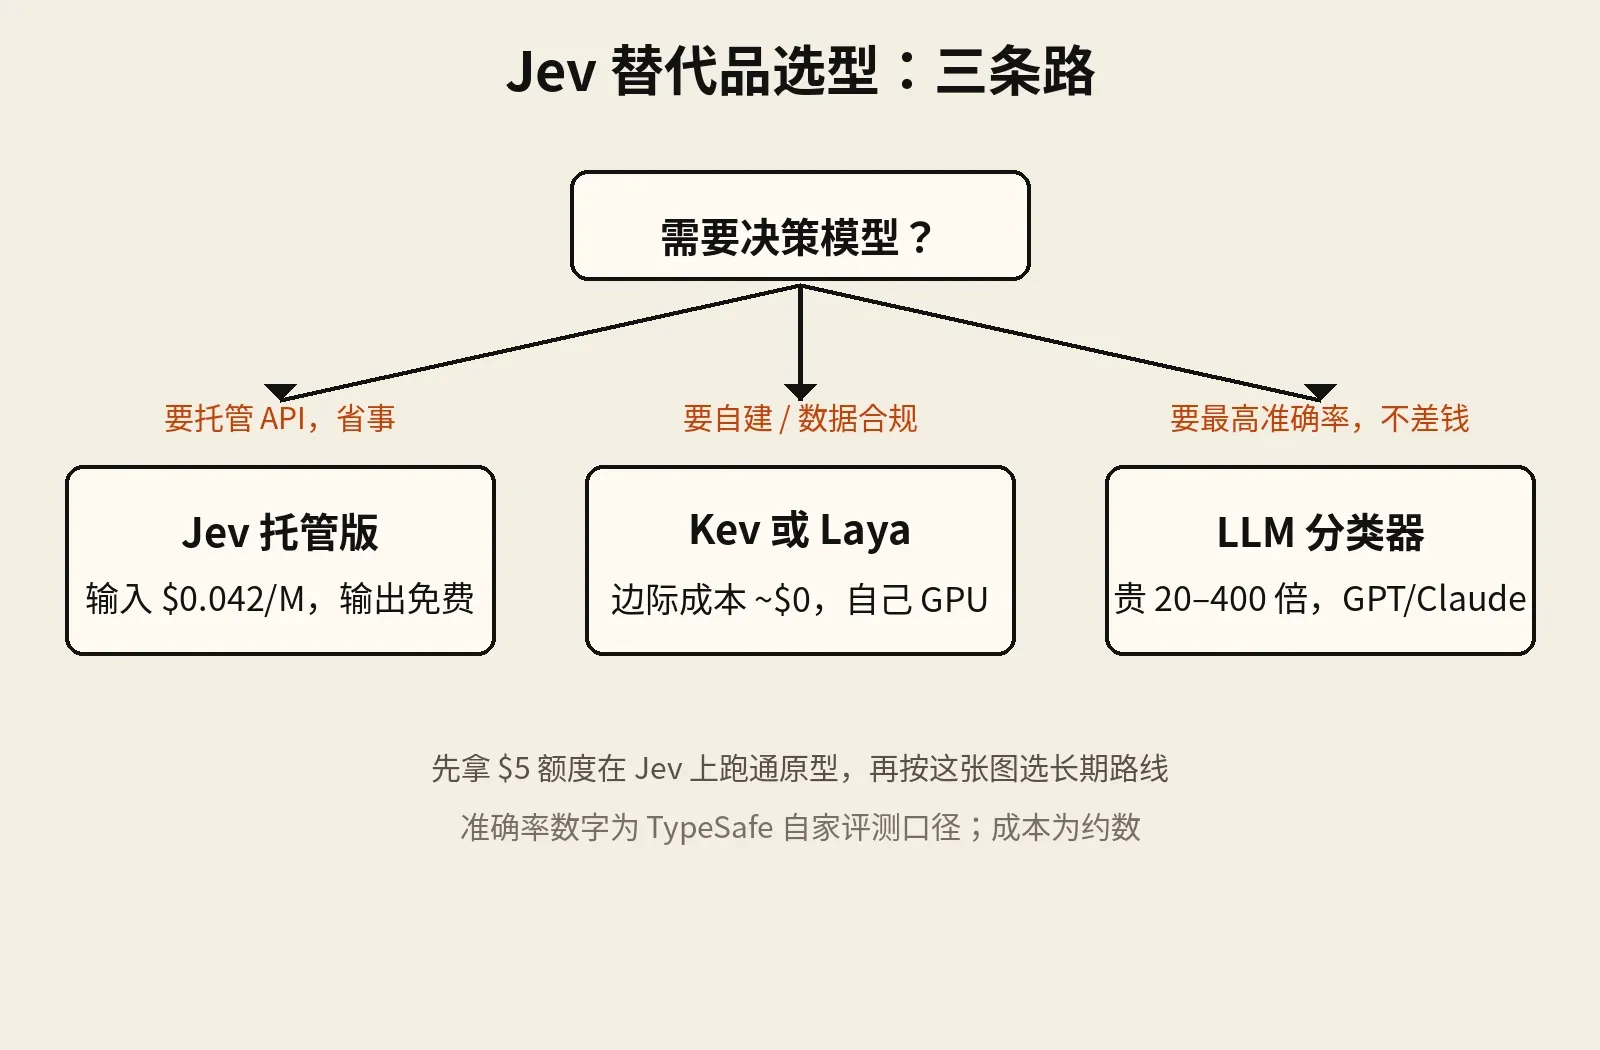
以后想从 Jev 迁出来:迁移 checklist
先在托管版 Jev 上做原型、再迁到自建平替的话,按这个顺序走——最后一步之前,每一步都可逆:
- 先冻结评测集。 动 infra 之前,存 500–1000 条真实决策 + Jev 的输出当基线。这是以后衡量每个平替的尺子。
- 本地起一个 B 桶服务(laya-serve 或 ollaya),后面挂 Kev 或 Laya。把** staging** 环境的客户端指向新 base URL——生产环境继续打 Jev。
- 拿评测集跑平替。 对比准确率和校准(confidence 分数、多次运行的可重复性)——独立测试说平替就输在这两项。
- 生产环境影子跑一周。 双写流量,记下分歧,人工抽看重要的那些。分歧率在你的场景可接受,再切换。
- 下表。 生产环境翻 base URL。Jev 的 key 留一个月当回滚绳——$5 的额度,当保险很便宜。
赚钱角度:替代品本身就是 margin 杠杆
这页为什么会出现在一个搞钱站:替代品就是商业模式。 托管版 Jev 已经便宜(输入 $0.042/M,输出免费,官方定价),但“便宜”在每月一亿次决策面前仍是成本项;而且有些客户的数据依法就不能出内网。
从上面四个桶自然长出来的打法:
- 拿 Jev 的 $5 额度做原型。 验证场景、找到 PMF、签下第一个付费用户。零 infra。
- 单量 economics 划算时,用托管版 Jev 扩量。 最快,准确率也诚实。
- 量或数据合规倒逼时,自建 Kev/Laya。 推理边际成本 → ~$0(自己的 GPU 和电),同一份“卖系统”合同的 margin 跳涨——还多了一个合规故事(“你的数据不出内网”),这是托管版 Jev 拿不下的客户。
最后这点值得加粗,因为它是整页含金量最高的销售话术:数据主权是可以收费的特性。 医疗、金融、法律行业的客户,经常根本不能用托管分类 API,再便宜也不行。自建 Kev + B 桶服务塞进客户 VPC,把合规 blocker 变成你的护城河——定价按“去掉的风险”定,而不是按 token 成本卷。一个这样的客户每月 $2k–5k 的 retainer,顶一百个按表计费的散户。
生意还是同一门生意——完整版在搞钱 playbook——但走平替路线,60% 的 margin 能变成 90%。还在看地形的话,从 Jev Hub 开始。
References
- DataCamp — top open-source Jev alternatives(7 个项目横评表):https://www.datacamp.com/blog/top-open-source-jev-alternatives
- explainx.ai — six Jev clones in two days(48 小时克隆 sprint):https://www.explainx.ai/blog/six-jev-clones-two-days-2026
- dev.to — open-source Jev alternatives you can self-host(Jev 兼容接口自建指南):https://dev.to/yanng981/open-source-jev-alternatives-system-one-models-you-can-self-host-i5e
- TypeSafe docs — 官方 Jev 定价(输入 $0.042/M,输出免费):https://docs.typesafe.ai/models
别只是读完,这周就去跑第一单
订阅后你会先收到一份「7 天验证清单」。
免费订阅